Tecnología médica·Estudio en Nature Medicine
Una IA experimental señala qué zonas de una imagen médica apoyan su respuesta
Una inteligencia artificial analizó diez tipos de imágenes médicas y señaló zonas relevantes en pruebas con conjuntos de datos internacionales. El trabajo evaluó imágenes ya existentes y todavía no demuestra que el sistema sea seguro ni que mejore la atención de pacientes.
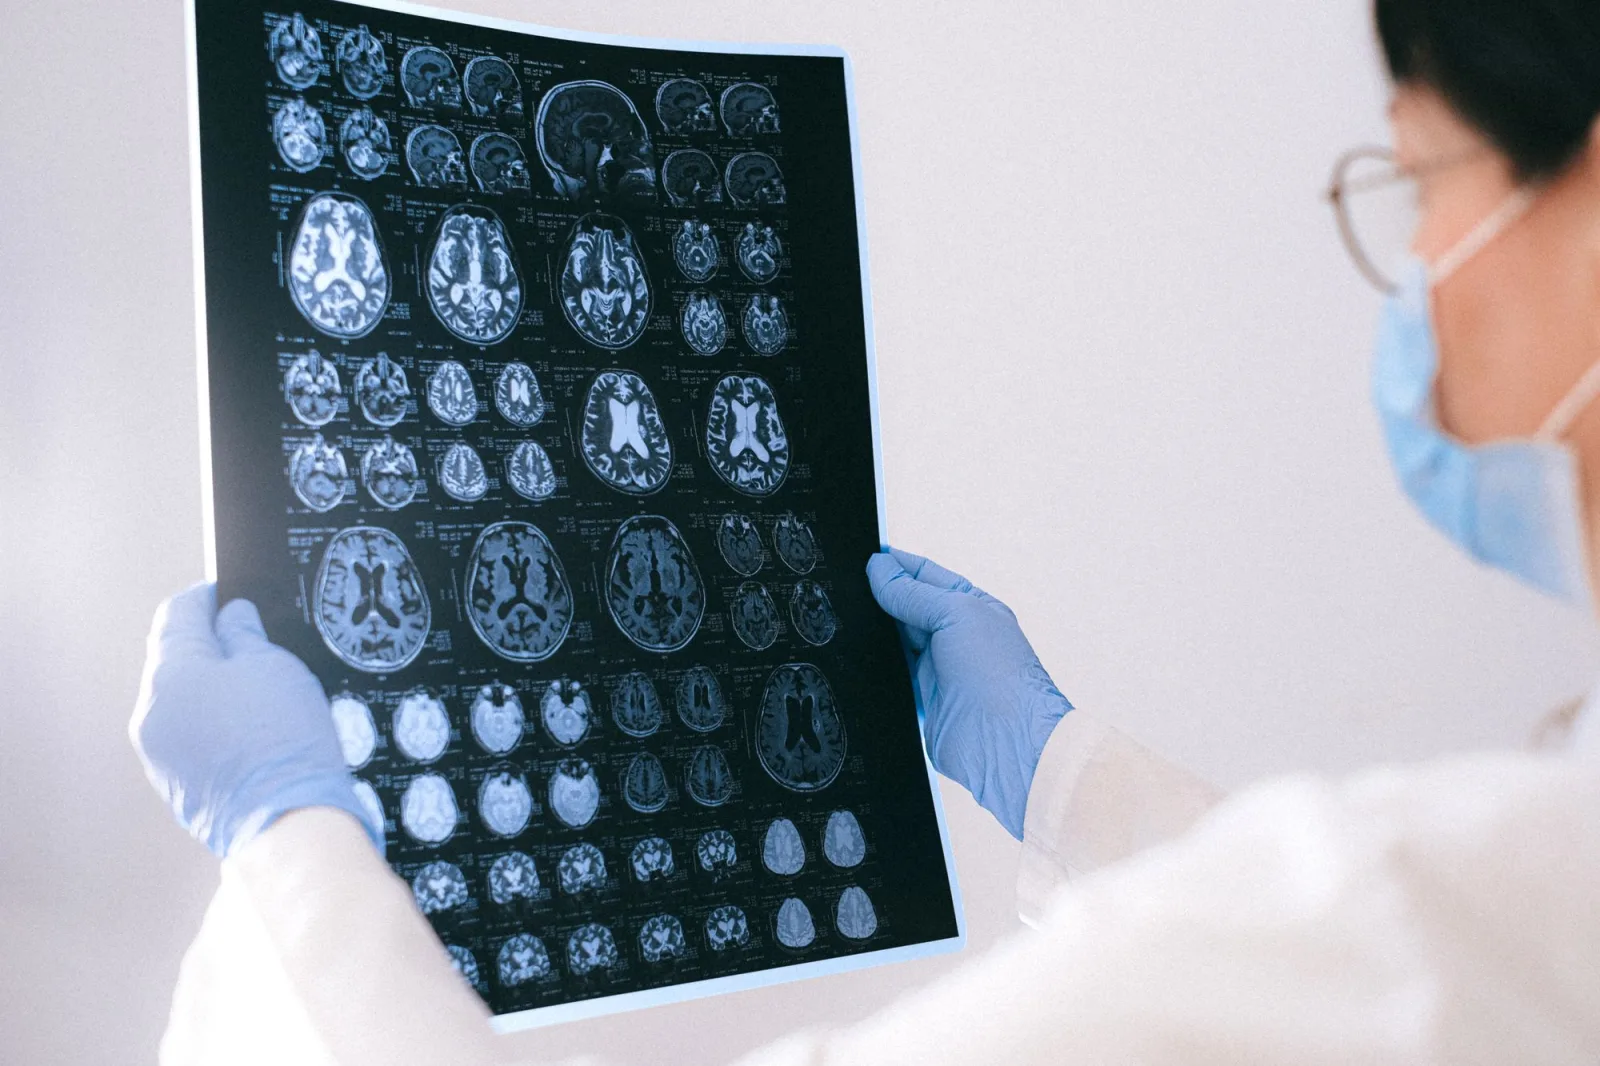
Cuando un médico te muestra una radiografía y señala una zona, la explicación resulta más fácil de seguir que una conclusión escrita sin referencias. Trasladar algo de esa claridad a la inteligencia artificial es el objetivo de un sistema experimental presentado en Nature Medicine. Además de proponer respuestas sobre imágenes médicas, puede marcar regiones relacionadas con lo que afirma. La posibilidad es atractiva: permitir que quien revisa una respuesta vea también qué parte de la imagen la acompaña. Eso todavía no garantiza que la respuesta sea correcta.
Qué hicieron
El equipo, encabezado por Yang Bai y con participación de A*STAR, el Singapore Eye Research Institute y Duke-NUS Medical School, en Singapur, desarrolló un modelo llamado EVLF-FM. El artículo se publicó el 29 de octubre de 2026. Su desarrollo y evaluación abarcaron más de 1,3 millones de muestras procedentes de 18 conjuntos de datos internacionales. El material cubría diez modalidades de imagen relacionadas con seis especialidades, entre ellas dermatología, oftalmología y radiología.
Entre las imágenes había radiografías, ecografías, tomografías, resonancias magnéticas, fotografías de la retina y muestras de tejidos observadas al microscopio. El propósito era que un mismo sistema pudiera trabajar con materiales diferentes. Lo entrenaron para clasificar enfermedades a partir de imágenes, contestar preguntas sobre ellas y localizar las regiones correspondientes a una descripción. Para aprender, recibió ejemplos y un entrenamiento que premiaba respuestas y localizaciones acordes con las referencias utilizadas por los investigadores.
Después compararon sus resultados con los de otros modelos generales y especializados. También lo sometieron a una evaluación externa con 13.443 muestras de 17 conjuntos adicionales. Esa separación permite comprobar cómo responde ante datos que no vio durante el entrenamiento. No fue un ensayo en el que pacientes recibieran atención con o sin la herramienta: se trabajó con datos existentes, sin un periodo de seguimiento para medir qué les ocurrió después a las personas.
Qué encontraron
En las pruebas internas de clasificación diagnóstica, EVLF-FM obtuvo una exactitud media de 0,895, la mayor entre los modelos comparados. La exactitud mide cuánto coinciden las respuestas con las etiquetas de referencia. Aquí se promediaron resultados de distintas tareas y conjuntos de datos, por lo que la cifra describe ese examen concreto. No permite calcular la probabilidad de que el sistema acierte si mañana recibe una imagen de cualquier persona en un hospital.
La capacidad de señalar regiones se evaluó comparando las zonas marcadas por el modelo con las anotaciones de referencia. En esas pruebas, realizadas en nueve modalidades, superó al sistema usado como comparación en las medidas de localización. Esto es distinto de acertar una enfermedad: mide hasta qué punto la región señalada coincide con la esperada. La combinación de ambas tareas permite vincular una respuesta escrita con una parte concreta de la imagen que un profesional puede inspeccionar.
Los investigadores también pidieron a médicos que evaluaran las explicaciones generadas. La valoración general fue favorable, aunque los especialistas detectaron omisiones de hallazgos clínicamente relevantes en algunos ejemplos. Las pruebas externas, por su parte, mostraron resultados competitivos ante otros modelos. Son señales de capacidad técnica que justifican seguir investigando, pero ninguna de esas comparaciones midió si una persona recibió antes el tratamiento adecuado o evitó una complicación gracias al sistema.
Lo que el estudio no dice
El límite principal está en la distancia entre responder bien a un conjunto de imágenes y ayudar con seguridad durante una consulta. Los autores señalan que hacen falta estudios prospectivos: pruebas planificadas en entornos clínicos que observen lo que ocurre cuando se incorpora la herramienta. Este trabajo no demuestra que reduzca errores asistenciales, mejore la salud de los pacientes o pueda reemplazar el juicio profesional. Tampoco presenta el modelo como un sistema listo para el uso rutinario.
Hay otra distinción menos visible: las explicaciones se generan después de la predicción. Aunque los investigadores evaluaron su relación con la evidencia, una explicación coherente no garantiza que reproduzca el proceso interno que produjo la respuesta. Marcar una zona plausible puede hacer que un resultado parezca convincente incluso cuando necesita corrección. Por eso, la posibilidad de revisar lo que muestra la IA es valiosa, pero no elimina la necesidad de comprobarlo.
Además, el sistema recibe imágenes estáticas de dos dimensiones y no procesa explícitamente el volumen completo de un examen. Los autores advierten que los datos disponibles tampoco recogen toda la diversidad de pacientes, equipos y enfermedades. Para Perú y otros países latinoamericanos, esto significa que los resultados no aseguran el mismo rendimiento en cada hospital: habría que comprobarlo con las poblaciones, imágenes y condiciones de atención locales.
El artículo declara conflictos de interés. Daniel Shu Wei Ting posee patentes relacionadas con sistemas de análisis de imágenes y acciones en EyRIS y aISIGHT. Arun Thirunavukarasu recibió financiamiento de HealthSense para investigación sobre aplicaciones biomédicas de modelos de lenguaje. Estos vínculos forman parte de la información necesaria para valorar el trabajo y refuerzan la importancia de evaluaciones independientes.
Para quien espera entender mejor un examen, el avance está en hacer más revisables las respuestas de una IA. Hoy, la imagen y su interpretación siguen necesitando el contexto de la persona y la revisión del profesional de la salud. El próximo paso decisivo será demostrar que añadir estas marcas y explicaciones ayuda durante la atención real, con beneficios medibles y sin introducir nuevos errores.
Fuentes y estudios
Los documentos de donde sale esta nota. Ábrelos y compara.
-
01
Abrir
Nature MedicineEstudio
A clinical multimodal vision language foundation model with fine-grain explainability
Artículo original de acceso abierto: diseño, resultados, límites, evaluación de explicaciones y conflictos de interés. Fecha corroborada en Crossref.
-
02
Abrir
PubMed (Nature Medicine)Estudio
A clinical multimodal vision language foundation model with fine-grain explainability
Resumen abierto del mismo estudio para comprobar las cifras principales y la necesidad de validación clínica; no es un segundo estudio independiente.
Enlaces comprobados al publicar la nota. Si alguno deja de funcionar, avísanos.